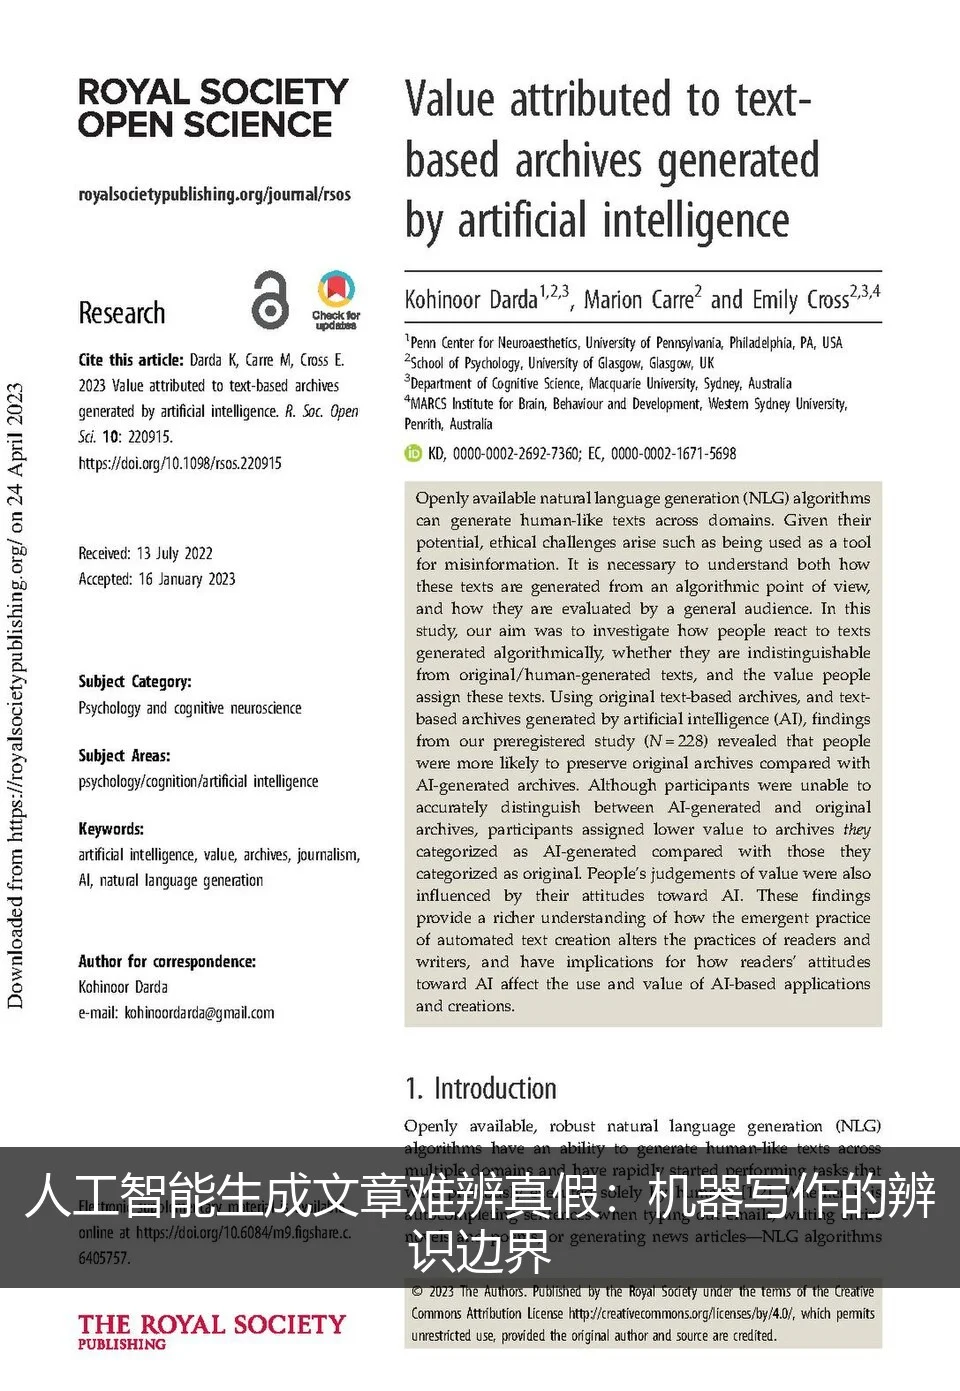
当一篇结构完整、语气自然的文章摆在面前,读者越来越难仅凭直觉判断它出自人手还是机器。人工智能生成文章难辨真假,并不是因为机器已经掌握了人类全部的表达能力,而是因为多数日常文本对“真实”的要求本就不高:观点通顺、逻辑连贯、语气得体,就足以通过阅读检验。真正需要追问的是,在什么条件下这种混淆成立,以及哪些线索仍然可靠。
简明的答案是:在缺乏外部核验渠道、文本本身不承载可验证事实时,人很难稳定区分;一旦引入来源追溯、事实核查和写作过程记录,辨识难度会显著下降。理解这一点,比单纯训练“语感”更有实际价值。
为什么读起来像人写的,却可能不是人写的
生成式模型的基本工作方式,是根据上下文预测下一个词的概率分布。它并不“知道”自己在写什么,而是在大量文本中学会了词语之间的搭配规律、段落之间的衔接习惯和常见文体的结构套路。这种训练目标恰好覆盖了人类写作中大量程式化的部分,例如说明文的起承转合、评论的立场铺陈、科普的类比解释。

因此,当一篇文章的主题常见、结构常规、不需要引用具体事实时,模型可以生成高度流畅的文本。读者感受到的“自然”,来自语言层面的统计合理性,而不是来自作者对世界的真实观察。混淆的根源在于:流畅性与真实性是两套不同的标准,前者容易被感知,后者需要额外验证。
哪些文本更容易被混淆,哪些不容易
区分难度与文本类型高度相关。观点评论、通用科普、经验总结、产品介绍这类以语言组织为主的文本,最容易被生成得难以分辨,因为它们对具体事实的依赖较低,读者也缺少对照物。相反,包含精确时间、地点、人物、数据和可追溯引用的报道,混淆空间较小,因为任何一处细节都可以被外部信息检验。
还有一个容易被忽略的变量是读者的知识储备。对某个领域熟悉的人,往往能察觉术语使用不当、论证跳跃或案例空泛;而面对陌生领域,读者只能依赖文本自身的连贯性作判断,这正是混淆最容易发生的场景。换句话说,辨识能力不只取决于文本,也取决于读者与文本之间的信息差。
常见辨识方法为什么不够可靠
依靠“机器味”判断并不可靠。模型输出的风格可以通过提示词调整,可以模仿特定文体,也可以刻意加入不规则的表达。反过来,人类写作中同样存在套话、重复和结构松散,单凭语言特征区分两者,误判率难以控制。
自动检测工具同样有边界。这类工具通常基于文本的统计特征或特定模型的输出痕迹作判断,但生成模型在迭代,检测依据会随之失效;对经过改写、翻译或人工润色的文本,检测结果更不稳定。把检测分数当作结论,容易产生虚假的确定感。更稳妥的做法是把检测结果视为线索之一,而不是终局裁决。
把辨识问题转化为核验问题
与其追问“这段文字像不像机器写的”,不如追问“这段文字里的主张能否被独立验证”。可操作的方向包括:检查文中是否给出可追溯的来源,关键事实能否在多个独立渠道交叉印证,作者或发布方是否提供写作过程与责任主体信息。对于数据、引语和事件描述,优先回到原始出处,而不是停留在转述层面。
内容平台和出版机构可以在流程上增加约束,例如要求标注生成工具的使用情况、保留编辑审核记录、对高风险内容执行事实核查。这些措施不能消除混淆,但能把“难以分辨”转化为“可以追责”,从而改变各方的行为激励。对普通读者而言,养成对无来源精确表述保持警惕的习惯,比训练直觉更有效。
值得持续观察的几个信号
第一个信号是内容来源标注能否形成稳定规范。如果生成内容的使用披露成为普遍做法,读者就有了判断的起点;如果披露停留在自愿层面,混淆成本仍会由读者承担。第二个信号是事实核查环节是否被真正嵌入发布流程,而不是事后补救。第三个信号是公众媒介素养的变化,即读者是否从依赖语感转向依赖核验路径。
人工智能生成文章难辨真假,本质上是语言流畅与事实可信之间的错位。技术会继续缩小文本层面的差异,但责任归属、来源透明和核验机制仍是人类可以主动设计的部分。判断一篇文章是否可信,最终不取决于它读起来多像人写的,而取决于它能否被检验、由谁负责。